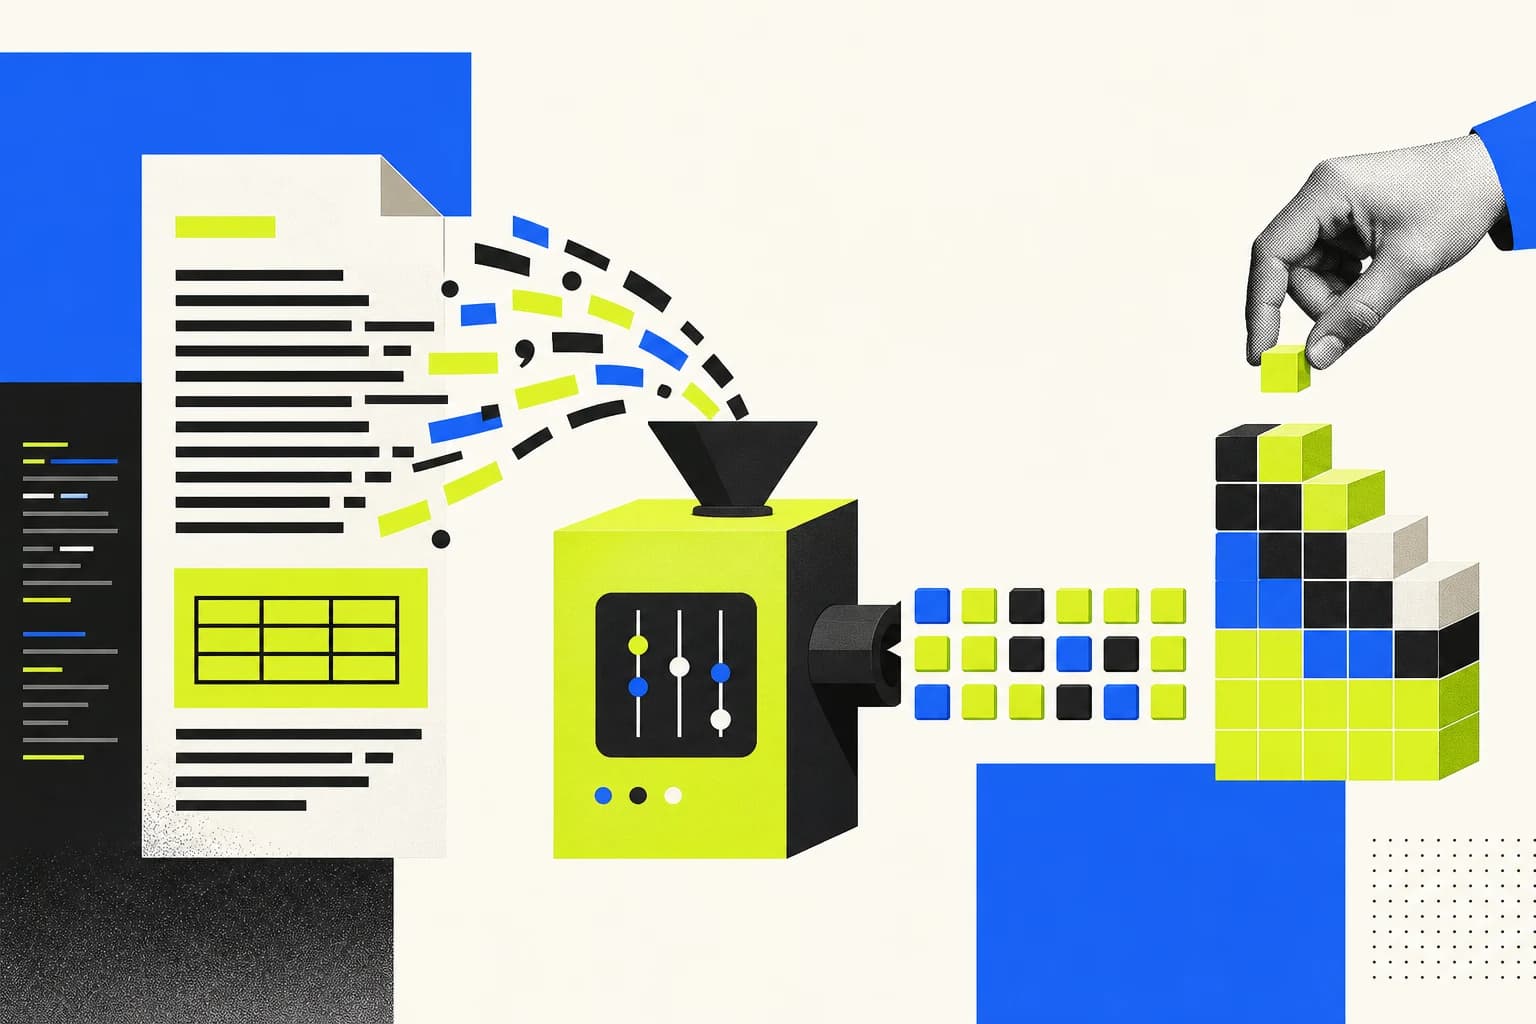
Когда вы отправляете запрос нейросети, она не видит «три страницы текста» или «десять слов». Сначала она разбивает содержимое на токены — небольшие части текста, с которыми умеет работать. В API именно число токенов обычно влияет на лимиты и стоимость запроса.
Это полезно знать не только разработчику. Маркетолог прикладывает отчёт по рекламе, менеджер — базу знаний, юрист — договор с приложениями. Вопрос может быть коротким, а основная часть расхода уйдёт на документ, историю чата и служебные инструкции.
Токен — это не слово и не символ
Токен может совпасть с коротким словом, быть частью длинного слова, знаком препинания, ссылкой или фрагментом кода. Поэтому десять слов не превращаются автоматически в десять токенов.
Фраза «Согласуйте сроки поставки до пятницы» состоит из шести слов. Но число токенов будет другим и зависит от конкретной модели: у каждой свой способ разбирать текст. В справке OpenAI о токенах можно посмотреть, как текст делится на такие части.
Правило «один токен — примерно четыре символа» относится к английскому и подходит только для очень грубой прикидки. Русский текст, таблицы, URL, код и распознанные сканы разбиваются иначе. Если от расчёта зависит бюджет, считайте токены инструментом той модели, которую будете запускать.
Почему миллион токенов не равен миллиону слов
Слова удобны человеку, но модели важна их внутренняя разбивка. Длинное слово может занять несколько токенов, а пунктуация — стать отдельной частью. Поэтому число страниц в PDF тоже не говорит точно, сколько будет стоить запрос.
Формат меняет расход не меньше объёма. Таблица с повторяющимися заголовками, JSON-файл с техническими полями и обычный текст одинаковой длины могут дать разное число токенов. Не стоит делить цену документа на количество страниц и считать результат точным.
Токены нужны модели не для того, чтобы «считать буквы». Это рабочие детали, из которых она строит смысл запроса и генерирует ответ. Чем больше деталей надо обработать, тем больше вычислений требуется сервису.
За что API списывает деньги
У запроса обычно есть входные и выходные токены. Входные — всё, что вы передали модели: системная инструкция, вопрос, история диалога, документ, примеры и описание подключённых инструментов. Выходные — ответ модели.
Некоторые сервисы отдельно показывают кэшированные токены: повторяющуюся часть контекста, которую удалось использовать из кэша. Отдельно могут тарифицироваться поиск, обработка файлов, выполнение кода, хранение кэша или внутренние рассуждения модели. Состав счёта зависит от провайдера и выбранной модели.
Для черновой оценки подойдёт такая схема:
Базовая стоимость запроса =
(новые входные токены × ставка входа
+ кэшированные токены × ставка кэша
+ выходные токены × ставка выхода) / 1 000 000
Плюс расходы на файлы, инструменты, хранение кэша
или внутренние токены — если сервис их учитывает.Не храните тарифы в старом шаблоне. Они меняются. Открывайте страницу цен выбранной модели в день расчёта и смотрите, какие типы токенов она учитывает.
Почему короткий вопрос не делает длинный PDF дешёвым
Менеджер загружает договор с приложениями и спрашивает: «Какие условия расторжения опасны для заказчика?» Сам вопрос занимает одну строку. Но если сервис отправляет весь PDF в контекст, большую часть входных токенов съест документ.
Затем менеджер открывает новый чат, снова прикладывает договор и спрашивает о сроках. В третьем чате проверяет штрафы. Если файл каждый раз уходит в модель целиком, три коротких вопроса становятся тремя обработками большого документа.
Но кнопка «Прикрепить файл» не объясняет механику. Один сервис может передать документ полностью, другой — найти подходящие фрагменты, третий — хранить файл отдельно. После первого запуска посмотрите поля `usage`: там обычно видно, сколько токенов реально ушло на вход и выход.
Для предварительного подсчёта у Gemini есть отдельный метод подсчёта токенов. Это полезнее, чем гадать по числу страниц, особенно перед массовой обработкой документов.
Контекстное окно — не бесконечная память
Контекстное окно — это объём данных, с которыми модель может работать в одном запросе. У многих моделей большой входной документ оставляет меньше места для ответа, но точные ограничения входа и выхода нужно смотреть в карточке конкретной модели.
Даже большой лимит не лечит хаос. Аналитик загружает годовую переписку, десять старых коммерческих предложений и таблицу правок, а потом просит «подробно сравнить условия». Материалы могут поместиться, но модель не знает, какая версия главная. Старые условия легко смешаются с новыми.
Перед таким запросом разделите документы по версиям, отметьте актуальную редакцию и вынесите нужные разделы в отдельную выжимку. Так вы снизите расход и получите ответ, который проще проверить.
Как не тратить токены впустую
Сначала отправляйте только то, что нужно для конкретного вопроса. Юрист проверяет штрафы в договоре поставки — ему не нужен архив писем, актов и старых редакций. Достаточно разделов о цене, ответственности и расторжении.
Второй шаг — ограничьте формат ответа. Фраза «проанализируй подробно» часто ведёт к длинной генерации. Лучше заранее попросить пять рисков, цитату, номер пункта и короткое пояснение.
Извлеки из текста только:
1. сроки и условия оплаты;
2. штрафы и неустойки;
3. условия одностороннего расторжения;
4. обязательства, которые создают риск для заказчика.
Для каждого пункта укажи:
— краткое объяснение;
— точную цитату;
— раздел или номер пункта;
— риск: низкий, средний или высокий.
Не пересказывай документ целиком.
Не добавляй сведения, которых в тексте нет.Третий шаг — не тащите в новый разговор старую историю. Команда месяц обсуждала запуск кампании, а теперь менеджеру нужна тема письма для другого продукта. Вместо всей переписки дайте модели короткую актуальную сводку: продукт, аудиторию, цель и тон. Вход станет дешевле, а ответ — чище.
Кэширование тоже может помочь, когда вы много раз задаёте вопросы к одному набору правил или документу. Но не считайте его гарантированной скидкой: автоматический кэш может не сработать, а явный кэш иногда требует оплаты хранения. Проверяйте фактический расход в `usage`.
Проверьте один тяжёлый запрос сегодня
Возьмите самый объёмный промпт из работы. Уберите один ненужный файл, старый блок переписки или расплывчатую инструкцию. Затем повторите запрос и сравните число входных токенов, цену и качество ответа.
Обычно главная утечка бюджета — не в вопросе и не в длине ответа. Она в привычке отправлять нейросети всё подряд. Токены делают этот расход видимым: оставляйте в контексте только данные, без которых модель действительно не справится.
Статья помогла?